一個月翻倍!數發部揭:台灣主權AI語料庫規模大躍進

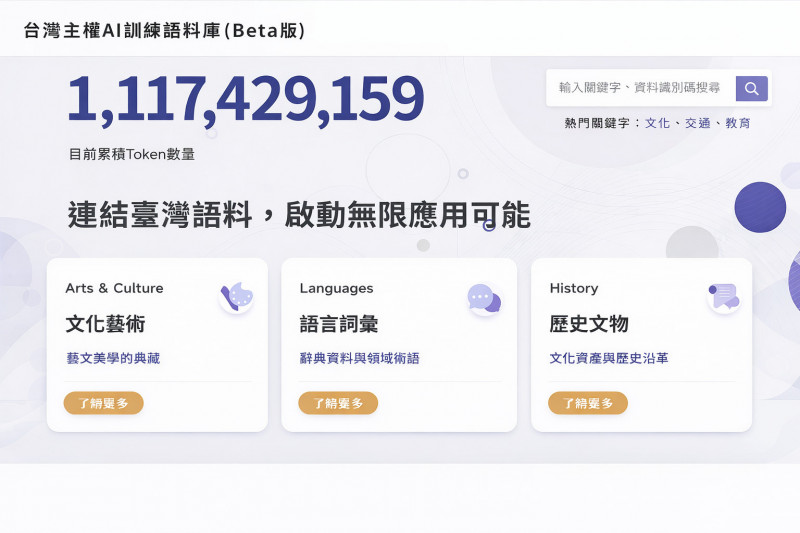 「台灣主權AI訓練語料庫」上線至今約一個多月,語料量成長速度明顯。(AI示意圖)
〔記者邱巧貞/台北報導〕為強化人工智慧(AI)發展的核心基礎,數位發展部(簡稱數發部)於2025年12月24日正式發布「台灣主權AI訓練語料庫」,廣納高品質正體中文語料,讓AI模型在訓練過程中,更貼近台灣的語言使用、文化脈絡與生活情境。
語料庫上線至今約一個多月,成長速度明顯。數發部資料創新司司長莊明芬今表示,平台初期累計上架逾2,000筆資料集、超過6億個tokens(詞元),目前語料規模幾乎翻倍,已突破11億個tokens,平台也會每週更新語料數量,反映各政府機關持續釋出資料的進度與投入程度。
這些語料資料充分反映台灣社會與文化的脈絡,涵蓋文化藝術、教育、語言詞彙、歷史文物、觀光旅遊與教育學習等,其中,來自文化部與教育部的資料占有相當比重,語言詞彙的部分還包含多種字詞典,是使用者查詢頻率極高的類型。
在使用熱度方面,語料庫網站目前累積瀏覽量已超過3.5萬次,莊明芬指出,這也顯示學界、研究單位、政府機關,甚至企業界,對於政府釋出高品質語料抱持高度關注,也為後續AI模型開發奠定良好起點,至今申請使用語料庫的單位約有二十多個,背景橫跨學術界、大專院校與產業界。
展望未來,數發部規劃自2026年第一、第二季起,逐步將AI語料來源由中央機關擴展至地方政府,並將舉辦說明會、正式發函邀請各縣市報名參與。首波將以制度說明與語料上架流程介紹為主,後續也不排除進一步規劃工作坊,協助地方政府實際操作與資料上傳。
莊明芬進一步指出,在與民間單位合作方面,官方預計於今年下半年逐步展開;上半年仍以中央與地方政府為優先對象,先行累積具體成果,建立外界對語料庫的信心,再逐步推廣至產業與學術單位。
目前語料內容仍以文化、教育、語言、歷史與地理等面向為主,後續也將與中央研究院、台灣文學館等單位洽談合作,進一步擴充資料的深度與廣度。不過她也坦言,各機關在釋出資料前,仍須完成授權條款確認與內部盤點等作業,相關流程仍需一定時間推進。
