


Vitalik:以太坊下一阶段的关键是什么?
 chaincatcher
作者:维塔利克·布特林
译者:嘉华、ChainCatcher
特别感谢平井洋一、贾斯汀·德雷克、纳迪姆·科贝西和亚历克斯·希克斯的反馈和评论。
在过去的几个月里,一种新的编程范式迅速在以太坊开发圈和计算机领域的许多其他方面获得了青睐:直接使用非常底层的语言(例如 EVM 字节码、汇编语言)或 Lean 编写代码,并使用用 Lean 编写的可自动验证的数学证明来验证其正确性。
如果运用得当,这种方法不仅有可能生成极其高效的代码,而且比以往的编程方法更加安全。平井洋一称之为“软件开发的终极形式”。
本文将尝试揭示软件形式化验证的基本原理,探讨其能够实现的目标,并指出其在以太坊和其他领域中的弱点和局限性。
什么是形式化验证?
形式验证是指以可自动验证的方式编写数学定理证明的过程。为了提供一个相对简单但有趣的例子,我们考虑斐波那契数列的一个基本定理:每三个数中就有一个是偶数,其余的都是奇数。
1 1 2 3 5 8 13 21 34 55 89 144 233 377 610 987 1597 2584 …
证明这一点的一个简单方法是通过数学归纳法,一次推进三个步骤。
首先是基本情况。设 F1 = F2 = 1,F3 = 2。通过观察,我们发现,当 i 为 3 的倍数时,命题(“当 i 为 3 的倍数时,Fi 为偶数;否则为奇数”)在 x = 3 之前成立。
接下来是归纳情况。假设该命题在 3k+3 之前成立,这意味着我们已经知道 F3k+1、F3k+2 和 F3k+3 的奇偶性分别为奇数、奇数和偶数。我们可以计算下一组三个数的奇偶性:
F3k+4 = F3k+2 + F3k+3 = 奇数 + 偶数 = 奇数
F3k+5 = F3k+3 + F3k+4 = 偶数 + 奇数 = 奇数
F3k+6 = F3k+4 + F3k+5 = 奇数 + 奇数 = 偶数
因此,已知该命题在 3k+3 之前成立,我们便可推导出该命题在 3k+6 之前成立。我们可以反复应用这种推理,从而确信这条规则对所有整数都成立。
这个论证足以说服人类。但是,如果你想证明一个复杂一百倍的论点,并且想绝对确定自己没有犯错呢?那么,你可以提供一个计算机也能接受的证明。
以下是它的呈现方式:
-- 斐波那契数列,其中 fib 0 = 0,fib 1 = 1,fib 2 = 1(索引偏移 1)
def fib : Nat → Nat
| 0 => 0
| 1 => 1
| n + 2 => fib (n + 1) + fib n
-- 声明:fib(3k+1) 是奇数,fib(3k+2) 是奇数,fib(3k+3) 是偶数。
换句话说:从斐波那契数列第 3 个数开始,每第三个数都是偶数。
我们通过对 k 进行归纳,一次性证明所有三个条件,因为每种情况
下一个模块由前一个模块构建而成。
定理 fib_triple (k : Nat) :
fib (3 * k + 1) % 2 = 1 ∧
fib (3 * k + 2) % 2 = 1 ∧
fib (3 * k + 3) % 2 = 0 := by
感应 k 与
| 零 => 决定
| succ k ih =>
将新的索引改写成(某个值)+ 2 的形式,以便 fib 展开。
精炼⟨?_, ?_, ?_⟩
· 显示 (fib (3 * k + 3) + fib (3 * k + 2)) % 2 = 1
欧米伽
·显示(fib(3 * k + 3) + fib(3 * k + 2) + fib(3 * k + 3)) % 2 = 1
欧米伽
· 显示 (fib (3 * k + 3) + fib (3 * k + 2) + fib (3 * k + 3)
+ (fib (3 * k + 3) + fib (3 * k + 2))) % 2 = 0
欧米伽
这是同样的推理逻辑,但用 Lean 语言表达。Lean 是一种常用于编写和验证数学证明的编程语言。
这看起来与上面给出的“人类”证明有所不同,这是有充分理由的:计算机的直觉(在“计算机”的传统意义上,指的是由 if/then 语句组成的“确定性”程序,而不是大型语言模型)与人类的直觉有着根本的不同。
在上面的证明中,你没有强调 fib(3k+4) = fib(3k+3) + fib(3k+2) 的事实,而是强调 fib(3k+3) + fib(3k+2) 是奇数,而 Lean 中的一种名为 omega 的策略会自动将此与 fib(3k+4) 的定义结合起来。
在更复杂的证明中,有时你必须明确指出哪个数学定律允许你采取当前步骤,有时你必须使用晦涩的名称,例如 Prod.mk.inj。
另一方面,你可以一步展开巨大的多项式表达式,并用像“omega”或“ring”这样的一行表达式来证明其有效性。
这种反直觉且繁琐的特性很大程度上解释了为什么尽管机器可验证证明已经存在近60年,该领域仍然十分小众。然而,另一方面,由于人工智能的飞速发展,许多以前不可能的事情现在正迅速成为可能。
当数学证明开始保护代码
到目前为止,你可能会想:嗯,计算机可以验证数学定理的证明,所以我们最终可以确定哪些关于素数的疯狂新结论是正确的,哪些只是数百页 PDF 论文中的错误。
或许我们还能弄清楚望月真一关于ABC猜想的观点是否正确!
但抛开好奇心不谈,那又怎样呢?
有很多可能的答案。但对我来说,一个非常重要的答案是验证计算机程序的正确性,特别是那些执行加密或安全相关任务的程序。
毕竟,计算机程序是数学对象,因此证明计算机程序以某种方式运行本身就是一个数学定理。
例如,假设你想证明像 Signal 这样的加密通信软件是否真正安全。你可以写下“安全”在这个语境下的数学含义。
从宏观层面来说,你所证明的是,假设某些密码学假设成立,只有拥有私钥的人才能知道消息内容的任何信息。但实际上,还有许多其他至关重要的安全属性。
原来确实有一个团队正在研究这个问题!他们的一项安全定理如下:
定理 passive_secrecy_le_ddh
(g:G)
(adv:PassiveAdversary G SK):
被动保密优势 (F := F) g adv ≤
ProbComp.boolDistAdvantage
(DiffieHellman.ddhExpReal (F := F) g (ddhReduction adv))
(DiffieHellman.ddhExpRand (F := F) g (ddhReduction adv))
以下是 Leanstral 对该含义的总结:
passivesecrecyle_ddh 定理是一个简洁的归约,它表明在随机预言机模型下,X3DH 的被动消息保密性至少与 DDH 假设一样难。如果攻击者能够破解 X3DH 的被动消息保密性,那么他们也能破解 DDH。
由于我们假设DDH难以破解,因此X3DH也能抵御被动攻击。该定理证明,如果攻击者能够被动地观察Signal的密钥交换消息,他们几乎不可能以高于可忽略的概率区分Signal生成的会话密钥和随机密钥。
如果将此与 AES 加密实现的正确证明结合起来,就可以证明 Signal 协议的加密能够抵御被动攻击者。
类似的项目也证明了 TLS 和其他浏览器内部加密技术的实现是安全的。
如果执行端到端的完整形式化验证,不仅能证明协议的某些理论描述是安全的,还能证明用户运行的具体代码在实践中也是安全的。
从用户的角度来看,这大大增强了无需信任感:要完全信任代码,你不需要检查整个代码库;你只需要检查那些已被证明的关于代码库的声明。
现在,有一些重要的注意事项需要牢记,特别是关于“安全”这个至关重要的词的真正含义。
人们很容易忘记证明那些真正重要的陈述。而且很容易发现,有时需要证明的陈述本身并不比代码更容易描述。
在证明过程中很容易无意间引入最终不成立的假设。同样,也很容易认为只需要对系统的一部分进行形式化证明,结果却发现其他部分(甚至硬件)存在严重的漏洞。
即使是精益实现本身也可能存在缺陷。但在讨论所有这些令人烦恼的细节之前,让我们先深入探讨一下正确且理想地完成形式化验证所能达到的理想状态。
形式化验证,专为安全而生
计算机代码中的漏洞令人恐惧。
当你把加密货币放入不可篡改的链式智能合约中,而朝鲜可以在代码出现漏洞时自动抽走你所有的资金,且你没有任何补救措施时,代码漏洞就变得更加可怕了。
当所有这些都被包裹在零知识证明中时,漏洞就变得更加可怕了,因为如果有人设法入侵了零知识证明系统,他们就可以提取所有的钱,而我们却不知道哪里出了问题(更糟糕的是,我们甚至不知道是什么时候出了问题)。
两年后,当我们拥有像 Claude Mythos 这样强大的 AI 模型,能够自动发现这些漏洞时,代码中的漏洞就变得更加可怕了。
有些人对这种现实的反应是主张放弃智能合约的基本理念,甚至认为互联网不能成为防御者对攻击者拥有不对称优势的领域。
一些引言:
要加固系统,你需要花费比攻击者利用漏洞所用代币更多的代币。
和:
我们的行业建立在确定性代码之上。编写代码、测试代码、部署代码,并确信代码能够运行,但以我的经验来看,这种模式正在被打破。
在真正以人工智能为核心的顶尖公司中,代码库已经成为你“信任”其运行的东西,你再也无法精确地指定其成功概率。
更糟糕的是,有些人认为唯一的解决办法就是放弃开源。
对于网络安全而言,这将是一个黯淡的未来。尤其对于我们这些关心互联网去中心化和自由的人来说,这是一种极其悲观的前景。
整个密码朋克精神从根本上建立在这样一个理念之上:在互联网上,防御者拥有优势,建造一座数字“城堡”(无论是通过加密、签名还是证明)比摧毁一座数字“城堡”要容易得多。
如果我们失去了这一点,那么互联网安全就只能依靠规模经济,依靠在全球范围内追捕潜在的攻击者,更广泛地说,就只能是在统治和毁灭之间做出选择。
我不同意;我对网络安全的未来抱有更乐观的看法。
我认为,人工智能强大的漏洞发现能力带来的挑战固然严峻,但这只是一个过渡阶段的挑战。一旦尘埃落定,我们达到新的平衡状态,我们将拥有一个比以往更有利于防御者的环境。
Mozilla同意我的观点。引用他们的话:
你可能需要重新调整其他所有事情的优先级,并将持续的、专注的精力投入到这项任务中,但隧道尽头终有光明。
我们为团队应对挑战的表现感到非常自豪,相信其他人也会如此。我们的工作尚未完成,但我们已经渡过了难关,并且看到了一个不仅能够勉强维持现状,而且会更加美好的未来。
防守方终于有机会取得决定性胜利了。……缺陷数量有限,我们正进入一个最终能够发现所有缺陷的世界。
现在,如果您使用 Ctrl+F 在 Mozilla 的帖子中搜索“形式化”和“验证”这两个词,会发现没有任何匹配项。网络安全的美好未来并非完全依赖于形式化验证或任何其他单一技术。
这取决于什么?本质上,就是这张图表:
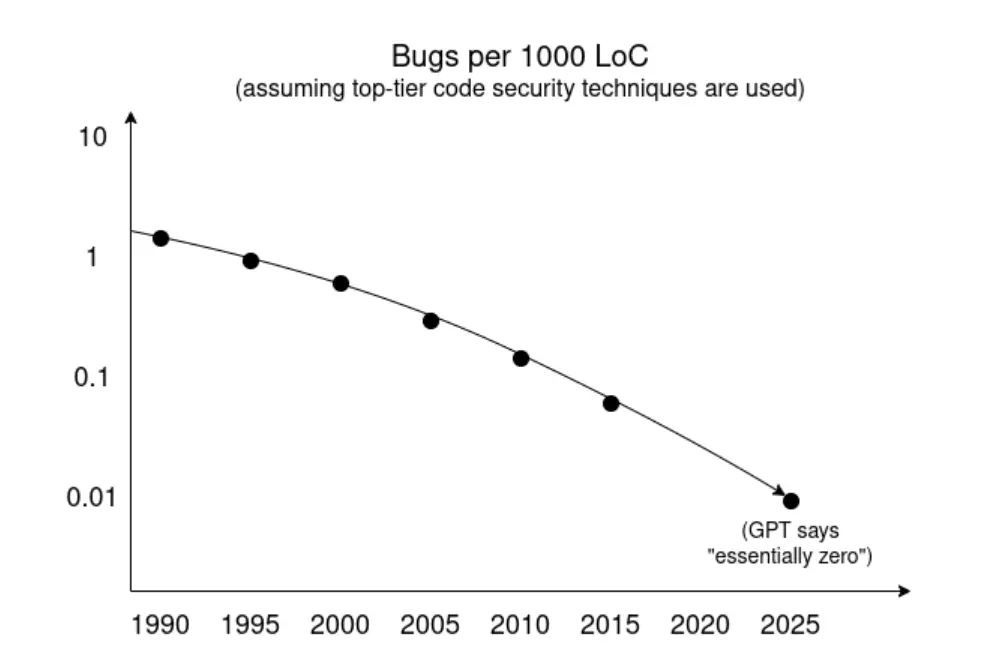
CVE漏洞随时间变化的趋势
几十年来,许多技术都为减少漏洞数量做出了贡献:
类型系统
内存安全语言
软件架构的改进(包括沙箱、权限控制,以及更广泛地将“可信计算基”与“其他代码”区分开来)
更好的测试方法
不断扩展的关于安全和不安全编码模式的知识库
越来越多的预先编写和审核过的软件库
人工智能辅助的形式化验证不应被视为一种全新的范式,而应被视为一种强大的加速器,推动着已经发展中的趋势和范式向前发展。
形式化验证并非万能灵药,但它尤其适用于目标远比实现简单的情况。对于以太坊下一个主要版本中需要部署的一些极其复杂且棘手的技术来说,这一点尤为重要,例如抗量子签名、STARK、共识算法和零知识证明虚拟机(ZK-EVM)。
STARK 是一个非常复杂的软件。但它实现的核心安全属性很容易理解和形式化:如果你看到一个哈希 H 指向程序 P,输入 x,输出 y,那么要么 (i) STARK 中使用的哈希算法已被破解,要么 (ii) P(x) = y。
因此,我们有了 Arklib 项目,该项目正在尝试创建一个完全经过形式验证的 STARK 实现(参见 VCV-io,它为各种其他加密协议的形式验证提供了基础预言机计算基础设施,其中许多协议都是 STARK 的依赖项)。
更具雄心的是 evm-asm:一个旨在构建完全形式化验证的完整 EVM 实现的项目。
这里的安全属性并不那么直接:本质上,目标是证明它与用 Lean 编写的另一个 EVM 实现等效,尽管该实现可以编写成最大限度地提高直观性和可读性,而无需考虑具体的运行时效率。
我们可能会得到十个 EVM 实现,它们在可证明上都是等效的,但它们都恰好包含同一个致命缺陷,该缺陷允许攻击者从他们未经授权访问的地址中窃取所有 ETH。
但这远比某些现有EVM实现中存在此类缺陷的可能性要小得多。另一个我们在经历了惨痛的教训后才意识到其重要性的安全属性——抵抗DoS攻击——也很容易形式化。
另外两个重要领域是:
拜占庭容错共识。虽然形式化所有预期的安全属性同样困难,但考虑到漏洞的普遍性,值得一试。因此,我们目前正在进行 Lean 实现,并利用 Lean 证明共识协议。
智能合约编程语言:参见 Vyper 和 Verity 中的形式化验证。
在所有这些案例中,形式化验证带来的巨大附加价值之一在于,这些证明是真正端到端的。通常,最令人头疼的错误是交互错误,它们潜藏在两个独立子系统的接口处。
对人类来说,要对整个系统进行端到端的推理太难了。但自动化规则检查系统可以做到。
形式化验证,为效率而生
我们再来看看evm-asm。这是一个EVM实现,但它是直接用RISC-V汇编语言编写的EVM实现。
真的。
以下是ADD操作码:
导入 EvmAsm.Rv64.Program
命名空间 EvmAsm.Evm64
打开 EvmAsm.Rv64
/-- 256 位 EVM ADD:二进制,弹出 2,压入 1。
肢体 0:LD、LD、ADD、SLTU(携带)、SD(5 个指令)。
肢体 1-3:LD、LD、ADD、SLTU(carry1)、ADD(carryIn)、SLTU(carry2)、OR(carryOut)、SD(每组 8 个)。
然后 ADDI sp,sp,32。
寄存器:x12=sp,x7=acc,x6=操作数,x5=进位,x11=进位1。 -/
def evm_add: 程序 :=
-- 肢体 0(5 条指令)
LD .x7 .x12 0 ;; LD .x6 .x12 32 ;;
添加 .x7 .x7 .x6 ;; SLTU .x5 .x7 .x6 ;; SD .x12 .x7 32 ;;
-- 第一部分(8 条说明)
LD .x7 .x12 8 ;; LD .x6 .x12 40 ;;
添加 .x7 .x7 .x6 ;; SLTU .x11 .x7 .x6 ;;
添加 .x7 .x7 .x5 ;; SLTU .x6 .x7 .x5 ;;
或者' .x5 .x11 .x6 ;; SD .x12 .x7 40 ;;
-- 第二部分(8 条说明)
LD .x7 .x12 16 ;; LD .x6 .x12 48 ;;
添加 .x7 .x7 .x6 ;; SLTU .x11 .x7 .x6 ;;
添加 .x7 .x7 .x5 ;; SLTU .x6 .x7 .x5 ;;
或者' .x5 .x11 .x6 ;; SD .x12 .x7 48 ;;
-- 第三部分(8 条指令)
LD .x7 .x12 24 ;; LD .x6 .x12 56 ;;
添加 .x7 .x7 .x6 ;; SLTU .x11 .x7 .x6 ;;
添加 .x7 .x7 .x5 ;; SLTU .x6 .x7 .x5 ;;
或者' .x5 .x11 .x6 ;; SD .x12 .x7 56 ;;
-- sp 调整
ADDI .x12 .x12 32
结束 EvmAsm.Evm64
之所以选择 RISC-V,是因为目前构建的 ZK-EVM 证明器通常通过证明 RISC-V 并将以太坊客户端编译为 RISC-V 来进行工作。因此,如果您有一个直接用 RISC-V 编写的 EVM 实现,这应该是您能获得的速度最快的实现。
RISC-V 也可以在普通计算机上非常高效地进行模拟(市面上也有 RISC-V 笔记本电脑)。
当然,要真正实现端到端验证,必须正式验证 RISC-V 本身的实现(或证明器的算术运算),但不用担心,这方面的工作已经存在了。
五十年前,我们常常直接用汇编语言编写代码。从那时起,我们就放弃了这种做法,转而使用高级语言编写代码。
高级语言虽然在效率上有所妥协,但作为交换,它们可以实现更快的编码速度,更重要的是,可以更快地理解其他人的代码,这对于安全性至关重要。
形式化验证与人工智能的结合,让我们有机会“重返未来”。
具体来说,我们可以让 AI 编写汇编代码,然后编写形式化证明来验证汇编代码是否具有所需的属性。
至少,所需的属性可以简单地等同于一个针对可读性进行了优化并用某种人类友好的高级语言编写的实现。
我们不再需要单个代码对象来平衡可读性和效率;相反,我们有两个独立的对象:一个(汇编实现)仅针对效率进行优化,同时考虑其特定执行环境的要求;另一个(安全声明或高级语言实现)仅针对可读性进行优化,然后我们通过数学证明来证明两者之间的等价性。
用户可以(自动)验证一次该证明,之后只需运行快速版本即可。
这种方法非常强大,平井洋一称之为“软件开发的终极形式”是有原因的。
形式化验证并非万能灵药
在密码学和计算机科学领域,存在着一种几乎与形式化方法本身的历史一样古老的传统:批评形式化方法(或者更广泛地说,批评对“证明”的依赖)的传统。
这些著作充满了实际案例。让我们从早期简单密码学时代的一些手写证明开始,并引用梅内泽斯和科布利茨在2004年提出的批评意见:
1979 年,拉宾提出了一种在某种意义上“可证明”安全的密码函数,这意味着它具有还原论安全属性。
还原论安全声明表明,任何能够从密文 y 中找到消息 m 的人也必须能够分解 n。……拉宾提出他的加密方案后不久,里维斯特指出,具有讽刺意味的是,正是这种赋予其额外安全性的特性,如果面对被称为“选择密文”的攻击者,将会导致其彻底崩溃。
也就是说,如果攻击者能够以某种方式诱骗 Alice 解密他们选择的密文,那么攻击者就可以按照 Sam 在上一段中用来分解 n 的相同步骤进行操作。
梅内塞斯和科布利茨随后提供了更多例子。常见的模式是,旨在使加密协议更“可证明”的设计往往会使它们变得不那么“自然”,从而更容易出现设计者从未预料到的故障。
现在,让我们回到机器可验证的证明和代码。这里有一篇 2011 年的论文,它发现了一个经过形式化验证的 C 编译器中的漏洞:论文:
我们发现的第二个 CompCert 问题表现为两个错误,导致生成以下代码:stwu r1, -44432(r1),其中分配了一个大的 PowerPC 堆栈帧。
问题在于 16 位位移字段溢出了。CompCert 的 PPC 语义没有对该立即数的宽度进行限制;他们假设汇编器会捕获超出范围的值。
还有一篇 2022 年的论文:
在 CompCert-KVX 中,提交 e2618b31 修复了一个错误:`nand` 指令被打印为 `and`;`nand` 指令仅在罕见的 `~ (a & b)` 模式中使用。该错误是通过编译随机生成的程序发现的。
时至今日,到了 2026 年,Nadim Kobeissi 是这样描述 Cryspen 中经过形式化验证的软件的漏洞的:
2025 年 11 月,Filippo Valsorda 独立报告称,libcrux-ml-dsa v0.0.3 在相同的确定性输入下,在不同的平台上生成了不同的公钥和签名。
该漏洞存在于内部包装函数 vxarqu64 中,该函数实现了 SHA-3 Keccak-f 置换中使用的 XAR 操作。回退机制将错误的参数传递给了移位操作,从而破坏了没有硬件 SHA-3 支持的 ARM64 平台上的 SHA-3 摘要。
这属于 I 类失败:内部函数已被标记,但整个 NEON 后端并未完成运行时安全性或正确性的证明。
和:
libcrux-psq 库实现了后量子预共享密钥协议。在 decrypt_out 方法中,AES-GCM 128 解密路径会对解密结果调用 .unwrap() 方法,而不是传播错误。格式错误的密文可能会导致进程崩溃。
这四个问题都属于以下两类之一:
有些情况下,只验证了部分代码(因为验证其余部分太困难了),结果发现未验证的代码比作者想象的漏洞更多(而且更致命)。
作者忘记指定需要证明的关键属性的情况。
Nadim 的文章对形式验证中的故障模式进行了分类;他还提供了其他类型的故障模式(例如,另一个主要情况是“形式规范本身是错误的,或者证明中包含被构造系统默默接受的错误陈述”)。
最后,我们可以考察软件和硬件边界处形式化验证的失败之处。这里常见的问题是验证系统对侧信道攻击的抵抗能力。
即使你使用了完全安全的加密形式来保护你的信息,如果几米之外的人能够捕捉到电信号的波动,并在经过数十万次加密后提取出你的私钥,你仍然是不安全的。
这是一篇关于“差异功率分析”的文章,这是此类技术的一个广为人知的例子:文章。
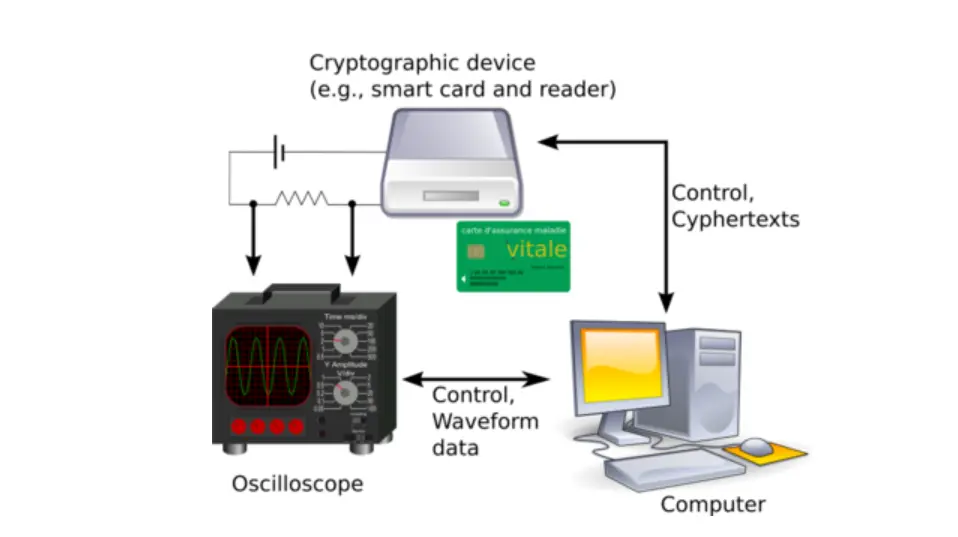
差分功率分析是一种常见的侧信道攻击。来源:维基百科
人们一直以来都在尝试证明系统能够抵御此类攻击。然而,任何此类证明都需要某种攻击者的数学模型,才能证明系统能够抵御这种模型。
有时会使用“d探测模型”:我们假设攻击者在电路中可以查询的位置数量存在已知上限。然而,某些形式的泄漏无法被该模型捕获。
正如本文所观察到的,一个常见问题是瞬态泄漏:如果您可以观察到一个信号,该信号不仅取决于某个位置的值,还取决于该值的变化方式,那么通常足以从两个值(旧值和新值)而不是一个值中恢复您需要的信息。
本文对其他形式的泄漏进行了分类。
几十年来,对形式化验证的这些批评意见一直有助于改进形式化验证。与过去相比,我们现在更能防范此类问题。但即便如此,它仍然不够完美。
从宏观角度来看,这里有一个主线:形式化验证非常强大。
但无论营销术语如何使形式化验证听起来像是能给你“可证明的正确性”,所谓的“可证明的正确性”从根本上来说并不能证明软件(或硬件)是“正确的”。
在大多数人的理解中,“正确”意味着:“事物的行为与用户对开发者意图的理解相一致”。
“安全”的含义类似于:“事物的行为不会违反用户的期望,也不会做出损害用户利益的事情。”
无论哪种情况,正确性和安全性最终都归结为数学对象与人类意图或期望之间的比较。
人类的意图和期望本身就是数学上复杂的对象;毕竟,人脑是宇宙的一部分,遵循物理定律,而如果你有足够的计算能力,就可以模拟这些定律。
但它们是极其复杂的数学对象,无论是计算机还是我们自己都无法理解甚至解读。
从实际意义上讲,它们就像黑匣子;我们之所以能够理解自己的意图和期望,仅仅是因为我们每个人都有多年观察自己想法和推断他人想法的经验。
因为我们无法将人类的原始意图塞进计算机,所以形式化验证无法证明与人类意图的比较。
因此,“可证明的正确性”和“可证明的安全性”实际上并不能证明我们人类所理解的“正确性”和“安全性”。除非我们能够完全模拟人脑,否则任何方法都无法做到这一点。
那么它有什么用呢?
我倾向于将测试套件、类型系统和形式验证视为编程语言安全同一底层方法的不同实现方式(这可能也是唯一合理的方法)。
它们都涉及以不同的方式重复地指定我们的意图,然后自动检查这些不同的指定是否彼此兼容。
以这段Python代码为例:
def fib(n: int) -> int:
如果 n < 0:
引发异常(“不支持负值”)
elif 0 <= n < 2:
返回 n
别的:
返回 fib(n-1) + fib(n-2)
如果 __name__ == '__main__':
assert [fib(i) for i in range(10)] == [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
断言 fib(15) == 610
在这里,您可以通过三种不同的方式表达您的意图:
具体来说,就是在代码中实现斐波那契公式。
隐式地,通过类型系统(指定递归中的输入、输出和中间步骤均为整数)
通过“示例包”方法:测试用例
运行该文件会将公式与示例进行比较。类型检查器可以验证类型是否兼容:两个整数相加是符合规范的操作,并且会得到另一个整数。
类型系统通常是检查物理学工作的好方法:如果你计算加速度,但最终得到的答案是米/秒而不是米/秒²,那么你就知道你犯了一个错误。
测试用例是“示例包”定义的一个实例,对于人类来说,这通常比直接明确的定义更能自然地处理概念。
你越能用不同的方式表达你的意图,理想情况下,这些方式应该要求你从不同的角度思考问题,一旦所有这些表达方式被证明是相互兼容的,你就越有可能真正表达出你真正想要的东西。
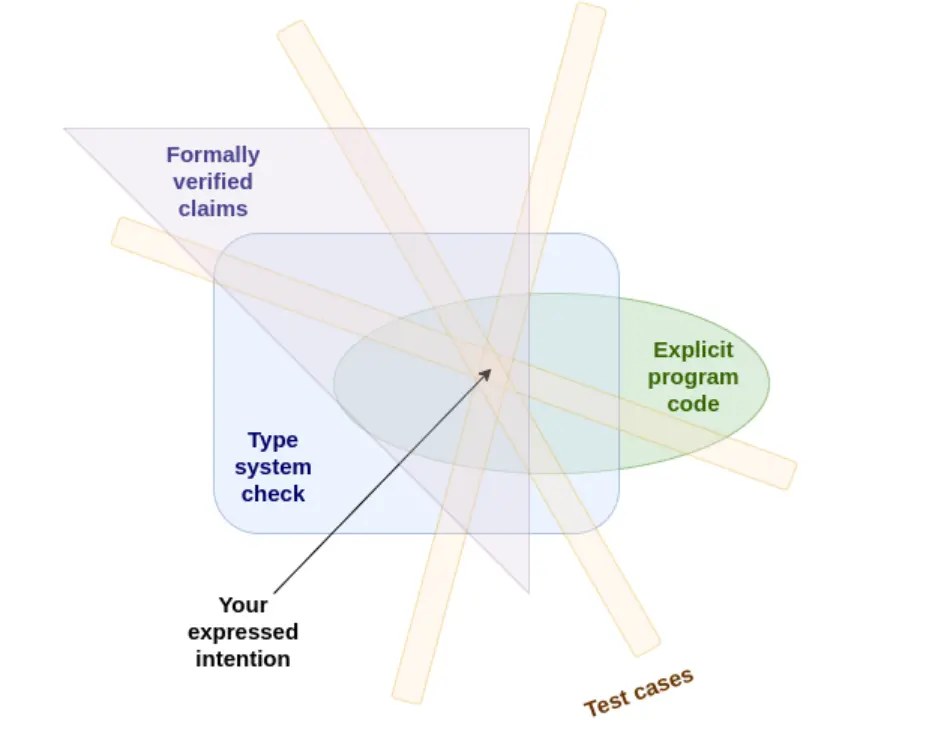
安全编程是指以多种不同的方式表达你的意图,然后自动验证所有这些表达方式是否彼此兼容。
形式化验证允许你进一步扩展这种方法。通过形式化验证,你可以用几乎无限多种不同的冗余方式来描述你的意图,只有当所有方式都兼容时,程序才能被验证通过。
你可以指定一个高度优化的实现和一个效率很低但易于理解的实现,并验证它们是否一致。你可以请十位朋友列出他们认为你的程序应该具备的数学性质,然后检查你的程序是否满足所有这些性质的要求。
如果测试不通过,则需要找出程序错误或数学属性定义不正确的原因。而人工智能可以极其高效地执行所有这些操作。
那么我该如何开始呢?
实际上,你不会自己写证明。形式化方法之所以一直不流行,是因为大多数人搞不懂这些晦涩难懂的东西该怎么写。你能告诉我下面这段代码是什么意思吗?
/-- 辅助函数:在折叠层级上逐点进行 ≤ 运算,并带有累加器。 --
私有定理 foldl_acc_le (ds1 ds2 : List Nat) (w : Nat) (ab : Nat) (hAcc : a ≤ b)
(hLE : Forall2 (· ≤ ·) ds1 ds2) :
List.foldl (λ acc d => acc * w + d) a ds1 ≤
List.foldl (λ acc d => acc * w + d) b ds2 := by
将 ds1、ds2、hLE 与
| [], [], .nil => 精确 hAcc
| d1::ds1', d2::ds2', .cons hd htl =>
simp [List.foldl]
精炼 foldl_acc_le ds1' ds2' w (a * w + d1) (b * w + d2) ?_ htl
精确 Nat.add_le_add (Nat.mul_le_mul hAcc (Nat.le_refl _)) hd
(如果您想知道,这是 SPHINCS 签名变体的特定安全声明证明中的众多子引理之一。)
具体来说,该声明是:除非发生哈希冲突,否则由一个哈希摘要(dig1)生成的消息的签名在哈希阶梯上的至少某个位置需要比任何其他消息的签名更高的值,因此包含无法从该其他签名计算出的信息。
你不需要手动编写代码和证明;你只需要让 AI 为你编写程序(无论是直接使用 Lean 语言还是为了提高速度使用汇编语言),并在过程中证明任何所需的属性。
这项任务的优点在于它是自我验证的,因此你不需要监督它;你只需让 AI 连续运行几个小时即可。
最糟糕的结果是它原地打转,毫无进展(或者,就像我的 Leanstra 曾经做的那样,它替换了被要求证明的陈述,以减轻自己的工作量)。
最后你唯一需要检查的就是它所证明的结论是否符合你的要求。
就 SPHINCS 签名变体而言,这是最终结论:
定理 wots_fullDigits_incomparable
{dig1 dig2 : 列表 Nat} {w l1 l2 : Nat}
(hw:0 < w)
(hLen1 : dig1.length = l1) (hLen2 : dig2.length = l1)
(hBound1:∀ d ∈ dig1,d < w)(hBound2:∀ d ∈ dig2,d < w)
(hL2suff : l1 * (w - 1) < w ^ l2)
(hNeq:dig1 ≠ dig2):
¬ 对于所有₂ (· ≤ ·) (wotsFullDigits dig1 w l1 l2) (wotsFullDigits dig2 w l1 l2) ∧
¬ 对于所有₂ (· ≤ ·) (wotsFullDigits dig2 w l1 l2) (wotsFullDigits dig1 w l1 l2)
这段文字实际上几乎难以辨认:
如果由一个哈希摘要(dig1)生成的数字与由另一个哈希摘要(dig2)生成的数字不相等
那么以下两个条件都不成立:
对于所有数字,dig1 中的数字 <= dig2 中的数字
对于所有数字,dig2 中的数字 <= dig1 中的数字
在通过添加校验和生成的“扩展数字”(wotsFullDigits)中,也就是说,在 dig1 的扩展中,必然会有一些地方的数字更大,而在其他地方,dig2 的扩展中的数字会更大。
就使用大型语言模型编写证明而言,我认为 Claude 和 Deepseek 4 Pro 都能够胜任。Leanstral 是一个规模较小的开源权重模型,专门针对编写 Lean 进行了优化,是一个很有前景的替代方案。
它有 1190 亿个参数,每个令牌激活 60 亿个参数,虽然速度较慢(在我的笔记本电脑上大约每秒 15 个令牌),但可以在本地运行。根据基准测试,Leanstral 的性能优于规模更大的通用模型:
根据我目前的个人经验,它的效果比 Deepseek 4 Pro 略差,但仍然非常有效。
形式化验证并不能解决我们所有的问题。
但是,如果我们希望互联网安全模式不再建立在信任少数几个强大的组织之上,我们就必须转向信任代码,这包括即使面对强大的 AI 对手也要信任代码。
人工智能辅助的形式化验证使我们朝着实现这一目标迈出了坚实的一步。
与区块链和 ZK-SNARKs 一样,人工智能和形式化验证也是高度互补的技术。
区块链赋予你开放的可验证性和抗审查性,但代价是隐私和可扩展性,而 ZK-SNARKs 则为你恢复了隐私和可扩展性(实际上,甚至比你以前拥有的还要好)。
人工智能赋予你编写大量代码的能力,但代价是准确性,而形式化验证则能为你恢复准确性(实际上,甚至比你以前拥有的还要高)。
默认情况下,AI 会生成大量极其仓促的代码,导致错误数量增加。
事实上,在某些情况下,容忍软件缺陷的增加是正确的权衡:如果缺陷很小,那么即使有缺陷的软件也比没有软件要好。
但网络安全的未来一片光明:软件将(继续)围绕“安全核心”分裂成“不安全的边缘部分”。
不安全的边缘部件将在沙箱中运行,仅被授予完成其任务所需的最低权限。
安全核心将管理一切。如果安全核心崩溃,所有数据都会丢失,包括您的个人数据、资金等等。但如果某个不安全的边缘组件崩溃,安全核心仍然可以保护您。
对于安全核心,我们绝不能允许存在缺陷的代码泛滥。我们将采取果断措施,保持安全核心的规模精简,甚至进一步缩小其规模。
相反,我们将把人工智能带来的所有额外性能投入到增强安全核心的安全性上,使其能够承受我们在高度数字化的社会中对其施加的极高的信任压力。
操作系统的内核(或至少其中的一部分)将成为这样一个安全的核心。
以太坊也将是其中之一。
希望至少对于所有非性能密集型计算,你使用的硬件能够达到三分之一的水平。
第四个方面是与物联网相关的系统。
至少在这些安全的核心中,“漏洞是不可避免的;你只能在攻击者之前尝试找到它们”这句老话将被推翻,取而代之的是一个更有希望的世界,在这个世界里,你将实现真正的安全。
但是,如果你愿意将你的资产和数据交给编写粗糙、可能会意外地将它们吞噬到黑洞中的软件,那么,你当然也有这样的自由。
以上内容仅用作资讯或教育之目的,不构成与BTCC相关的任何投资建议。BTCC竭力但不能保证上述全部内容的真实性、准确性和原创性。