廣納高品質正體中文語料!數發部啟動「台灣主權AI訓練語料庫」

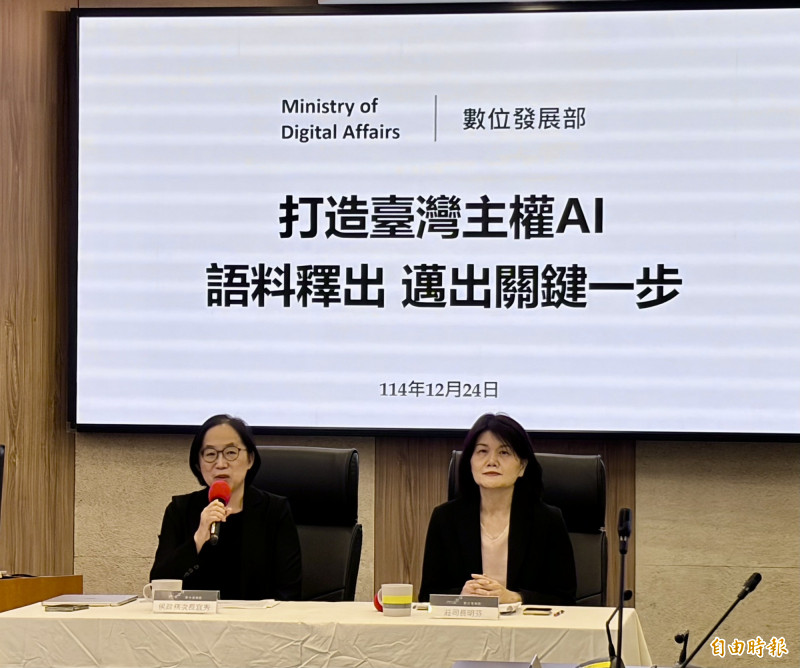 數位發展部24)正式發布「臺灣主權AI訓練語料庫」。(記者邱巧貞攝)
〔記者邱巧貞/台北報導〕在全球AI技術快速演進的趨勢下,台灣也積極布局本土化發展。數位發展部(簡稱數發部)於今(24)日正式發布「臺灣主權AI訓練語料庫」,廣納高品質正體中文語料,期望支援AI模型訓練更貼近台灣的語言、文化與生活情境,提升模型的本土辨識力與語意理解能力,回應我國社會與產業需求。
數發部指出,目前已有超過200個政府機關參與,累計上架逾2000筆資料集、超過6億個tokens,內容涵蓋語言、文化、教育、生物、地理環境等多元領域。這些具備台灣文化特色的高品質資料集,如同AI的「教材」,能協助模型更深入理解台灣社會,學習更自然、貼近在地的語言表達方式。
活動現場,各部會也分享參與成果。文化部所上架的公共藝術與文化資產相關資料集,展現台灣豐富且多元的藝文風貌,可作為訓練AI模型認識台灣文化內容的重要素材;教育部提供的語言辭典資料則涵蓋台語、客語及國語等,有助於強化AI模型的用詞精準度與語意理解能力。
為了讓政府機關與民間能夠「放心釋出資料、安心使用語料」,數發部並與經濟部智慧財產局合作,推出《臺灣主權AI訓練語料授權條款-第1版》,建立明確的授權依據。此舉可降低個別著作權協商所需的行政成本,減少AI訓練資料可能引發的著作權爭議,透過授權條款先行機制,加速主權AI的發展與應用。
此外,語料庫也串接政府資料開放十餘年來的成果,將過往累積的豐富文本開放資料同步整合,使用者可依需求查詢與下載所需語料,使資料更易於被查找與應用。
數位發展部次長侯宜秀也表示,語料庫的發布只是一個起點,「我們認為『醜媳婦不怕見公婆』,還是希望能先跟大家分享這個起點。」她強調,台灣主權AI訓練語料庫是一項「沒有終點的計畫」,只要台灣持續存在,語料庫就會持續更新。從中央機關逐步推廣至地方政府及民間機構,邀請更多單位共同參與,透過公私協力,攜手推動台灣主權AI的發展。
